NVIDIA Nemotron 3.5 Lightning est un modèle open weights de 30 milliards de paramètres, mais il n’en active que 3 milliards à chaque passage. Sa promesse n’est pas de remplacer tous les modèles frontier. Elle est plus concrète : exécuter rapidement et localement les nombreux appels produits par des agents IA de longue durée.
Nous l’avons déployé avec vLLM sur deux NVIDIA RTX PRO 6000 Blackwell Server Edition, puis mesuré jusqu’à 32 requêtes concurrentes. Le résultat le plus intéressant n’est pas un score abstrait : dans notre configuration, le modèle atteint 2 512 tokens de sortie par seconde en charge et reste dans un profil interactif jusqu’à une concurrence de 16.
Voici ce qu’il faut retenir de son architecture, des benchmarks publics et surtout de nos premiers résultats en conditions réelles.
Nemotron 3.5 Lightning en bref
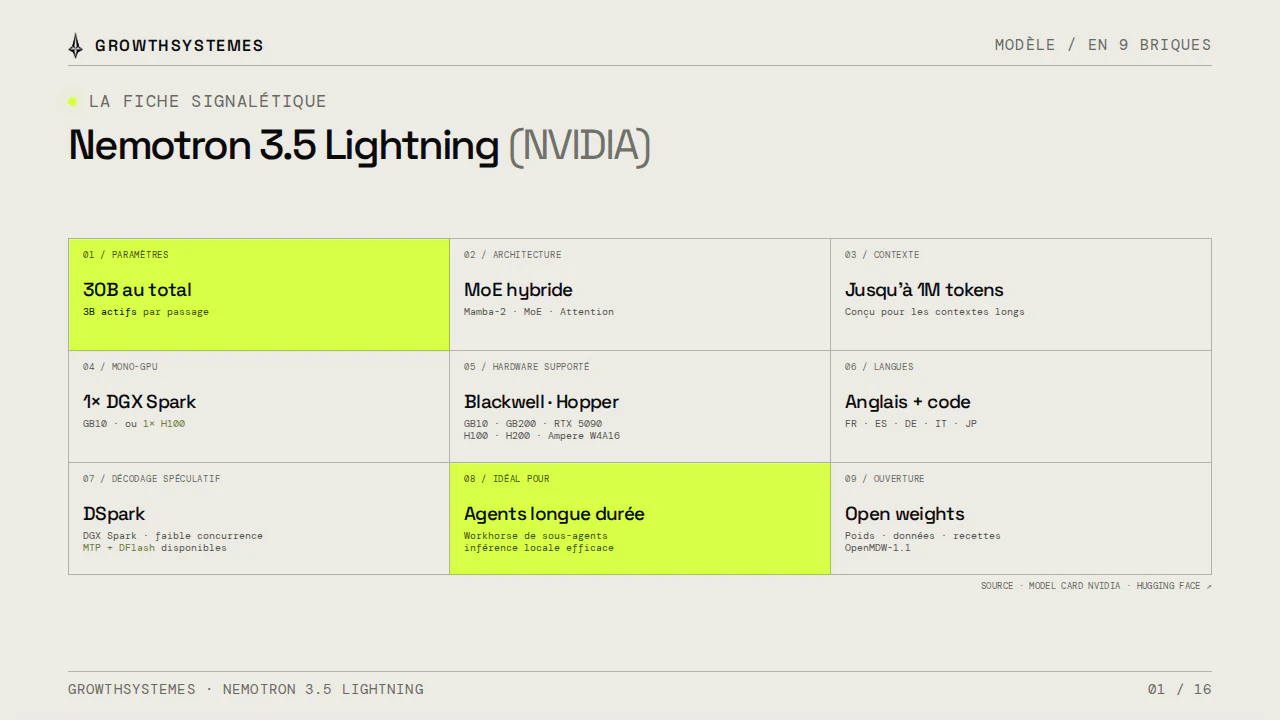
Nemotron 3.5 Lightning est un modèle Mixture-of-Experts hybride Mamba-Transformer conçu pour les tâches spécialisées et répétitives au sein de systèmes agentiques. NVIDIA publie les poids, des données et les recettes d’entraînement sous licence OpenMDW-1.1.
| Caractéristique | Nemotron 3.5 Lightning |
|---|---|
| Paramètres totaux | 30 milliards |
| Paramètres actifs | 3 milliards par passage |
| Architecture | Mamba-2 + attention + MoE + Multi-Token Prediction |
| Experts | 128 routés, top-6, plus 1 expert partagé |
| Fenêtre de contexte | Jusqu’à 1 million de tokens |
| Langues principales | Anglais et code, avec prise en charge du français, de l’espagnol, de l’allemand, de l’italien et du japonais |
| Checkpoint testé | NVFP4 |
| Cas d’usage cible | Sous-agents, appels d’outils, extraction, vérification et exécution locale |
La recette officielle Nemotron 3.5 Lightning documente 52 couches, une dimension cachée de 2 688 et 128 experts routés. Le checkpoint NVFP4 publié par NVIDIA fournit les poids directement exploitables pour l’inférence.
Pourquoi ce petit modèle est aussi rapide
Un modèle dense de 30 milliards de paramètres sollicite l’ensemble de ses poids pour produire chaque token. Nemotron 3.5 Lightning suit une logique différente : son routeur ne sélectionne que six experts parmi 128, auxquels s’ajoute un expert partagé. Environ 3 milliards de paramètres sont donc actifs lors d’un passage.
Cette parcimonie réduit le calcul, mais elle n’explique pas tout. L’architecture combine plusieurs techniques complémentaires :
- Mamba-2 traite efficacement les longues séquences ;
- des couches d’attention conservent une capacité de rappel précis dans le contexte ;
- le Mixture-of-Experts dirige chaque token vers une petite partie du réseau ;
- la Multi-Token Prediction permet de prédire plusieurs tokens futurs et d’accélérer le décodage spéculatif ;
- la quantification NVFP4 réduit fortement l’empreinte mémoire du checkpoint.
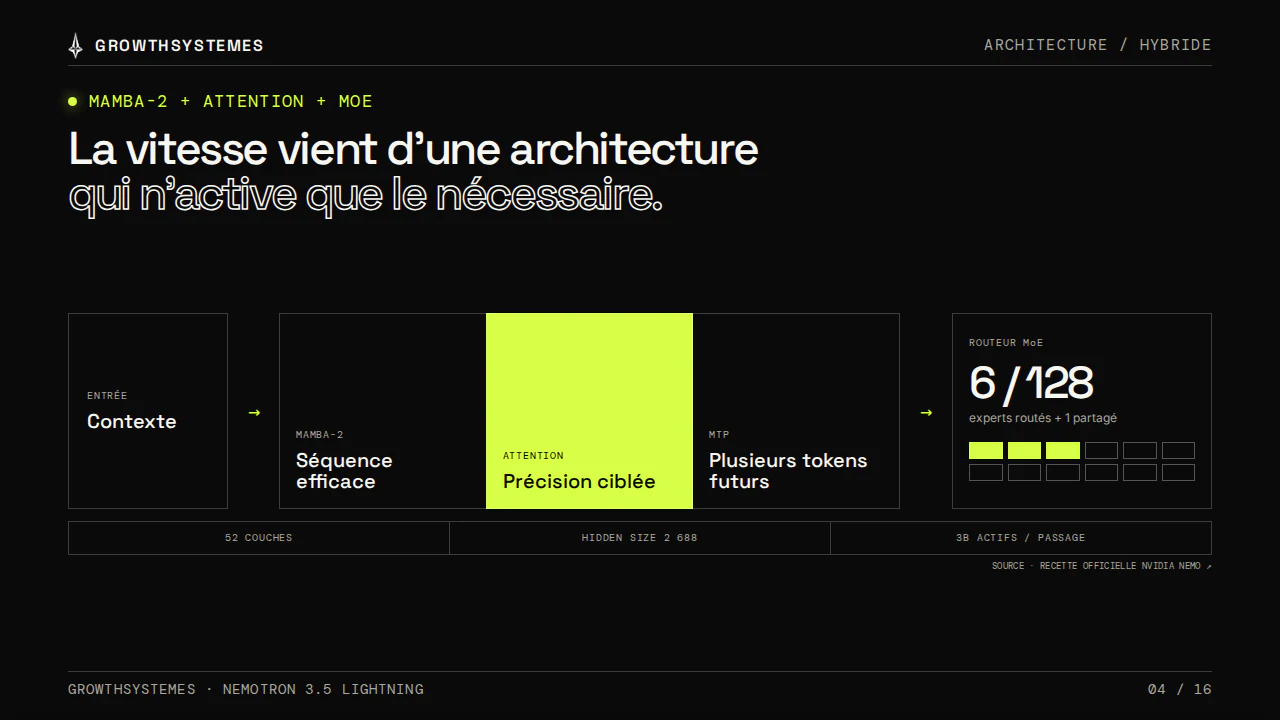
NVIDIA indique que le checkpoint passe d’environ 66 Go en BF16 à 22 Go en NVFP4, avec jusqu’à quatre fois plus de throughput selon le matériel et le scénario. Ce résultat vient d’une quantification post-entraînement suivie d’une distillation consciente de la quantification, destinée à récupérer une partie de la précision perdue. La chaîne complète est décrite dans la documentation d’entraînement NVIDIA.
Le modèle propose également plusieurs voies de décodage spéculatif. MTP vise surtout les charges moyennes ou fortes ; DSpark est destiné au DGX Spark et aux scénarios de faible concurrence ; DFlash est aussi disponible. Le meilleur choix dépend donc moins d’un classement général que de la forme réelle du trafic.
Une chaîne d’entraînement plus ouverte que la moyenne
Nemotron 3.5 Lightning est intéressant par son déploiement, mais aussi par le niveau de détail publié autour de sa fabrication. NVIDIA décrit une chaîne en quatre grandes étapes :
- un préentraînement avec un curriculum en deux phases, d’abord diversifié puis recentré sur des sources de meilleure qualité, avec une extension au contexte long ;
- un supervised fine-tuning couvrant plus de douze domaines, dont le code, les mathématiques, les STEM, l’usage d’outils et le multilingue ;
- un apprentissage par renforcement dans sept environnements de récompense, avec GRPO, GenRM et DPO ;
- une quantification NVFP4 suivie d’une distillation consciente de la quantification.
Ce niveau d’ouverture ne signifie pas que n’importe qui peut reproduire exactement le modèle sur une machine de bureau. Le préentraînement exige évidemment une infrastructure importante, et NVIDIA précise que les recettes ouvertes s’appuient sur le sous-ensemble public des données : leurs résultats peuvent différer des benchmarks du modèle publié. L’intérêt est ailleurs. Une équipe peut inspecter la méthode, adapter certaines étapes à ses données et retracer beaucoup plus précisément l’origine du modèle qu’avec une API entièrement fermée.
Nos résultats sur deux RTX PRO 6000 Blackwell
Nous avons servi le checkpoint NVFP4 avec vLLM 0.27.1 sur deux RTX PRO 6000 Blackwell Server Edition de 96 Go chacune. Le déploiement utilise le tensor parallelism sur deux GPU, l’expert parallelism et un cache KV en FP8. Prometheus et NVIDIA DCGM assurent le suivi du service et du matériel.
Au moment de la mesure, le service était stable : aucun redémarrage, aucune erreur de mémoire et aucun traceback. Les quatre cibles de monitoring répondaient, et l’API exposait bien la fenêtre maximale de 1 048 576 tokens.
Quelques repères sur l’allocation mémoire par GPU après le benchmark :
- environ 86,7 Go de VRAM utilisés et 8,3 Go libres ;
- environ 67,8 Go de cache KV par worker ;
- environ 9,7 Go de poids par worker ;
- une capacité totale de cache estimée à 46,64 millions de tokens ;
- une concurrence théorique de 44,48 séquences au contexte maximal.
Ces nombres décrivent la configuration, pas la qualité du modèle. Ils montrent toutefois l’intérêt du checkpoint NVFP4 : les poids occupent une fraction de la mémoire, ce qui laisse beaucoup de place au cache KV et donc aux conversations longues ou aux requêtes concurrentes.
Benchmark avec 1 024 tokens d’entrée et 256 de sortie
Nous avons ensuite fait varier la concurrence de 1 à 32 avec des prompts de 1 024 tokens et 256 tokens de sortie.
| Concurrence | Requêtes/s | Tokens de sortie/s | Tokens totaux/s | TTFT p95 | Latence p95 de bout en bout |
|---|---|---|---|---|---|
| 1 | 0,78 | 198 | 1 004 | 122 ms | 1 451 ms |
| 2 | 1,67 | 428 | 2 167 | 179 ms | 1 369 ms |
| 4 | 3,31 | 847 | 4 289 | 267 ms | 1 426 ms |
| 8 | 4,95 | 1 266 | 6 412 | 452 ms | 1 676 ms |
| 16 | 7,10 | 1 817 | 9 196 | 745 ms | 2 315 ms |
| 32 | 9,81 | 2 512 | 12 717 | 1 291 ms | 3 461 ms |
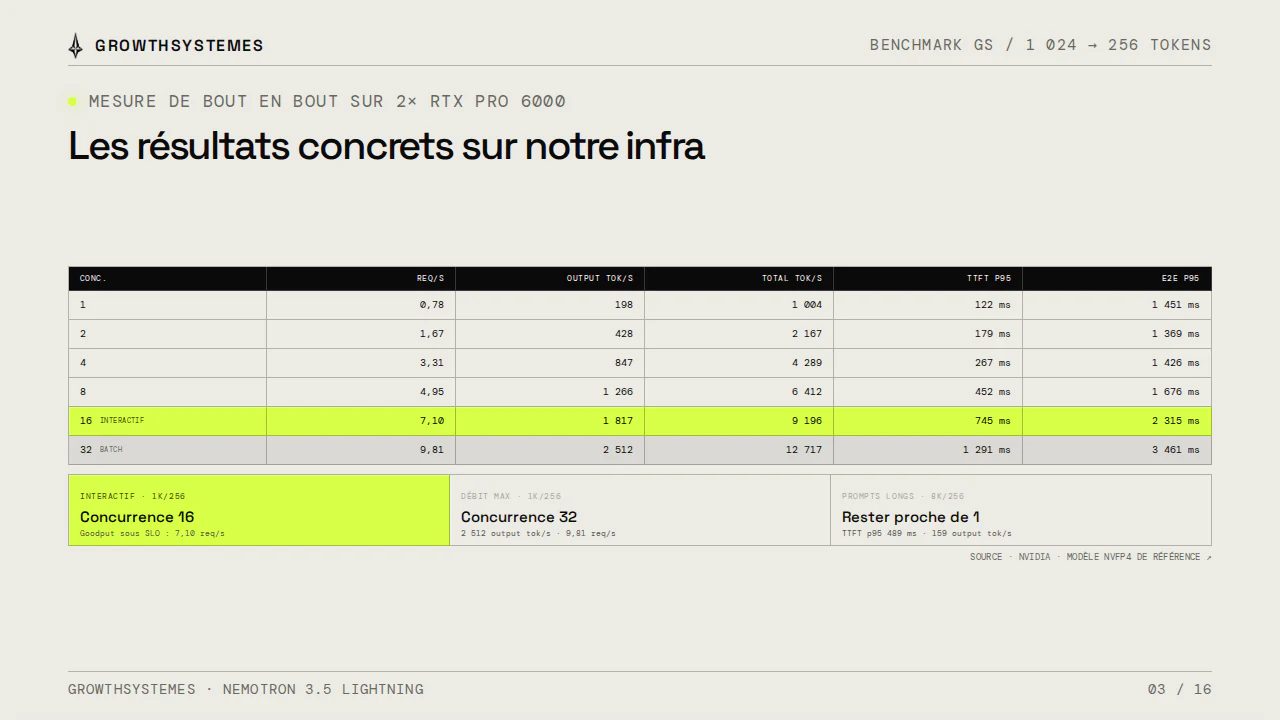
Le meilleur réglage dépend du service attendu :
- pour un trafic interactif, la concurrence 16 offre ici le meilleur goodput tout en maintenant un TTFT p95 inférieur à une seconde : 7,10 requêtes et 1 817 tokens de sortie par seconde ;
- pour un traitement batch, la concurrence 32 maximise le débit brut avec 2 512 tokens de sortie par seconde, au prix d’un TTFT p95 de 1,29 seconde ;
- pour des prompts de 8 000 tokens sensibles au temps avant le premier token, il vaut mieux rester proche d’une concurrence de 1. Nous avons alors mesuré un TTFT p95 de 489 ms et 159 tokens de sortie par seconde.
Il ne faut pas confondre ces mesures avec les 669 tokens par seconde publiés par Artificial Analysis. Ce dernier chiffre provient d’un endpoint privé DeepInfra de pré-lancement avec les poids NVFP4 finaux. Les nôtres sont des mesures de bout en bout sur notre propre infrastructure et sous plusieurs niveaux de concurrence. Le matériel, le runtime, la longueur des séquences et la charge changent radicalement le résultat.
Que disent les benchmarks publics ?
Par rapport à Nemotron 3 Nano, qui reste dans la même classe de taille 30B-A3B, Lightning progresse sur les quatre indicateurs mis en avant par Artificial Analysis :
| Indicateur | Nemotron 3 Nano | Nemotron 3.5 Lightning |
|---|---|---|
| Intelligence Index | 15 | 24 |
| Vitesse de sortie | 230 tok/s | 669 tok/s |
| GDPval-AA v2 | 490 Elo | 824 Elo |
| Terminal-Bench 2.1 | 6,7 % | 24,3 % |
L’analyse indépendante du lancement par Artificial Analysis montre donc un gain qui ne concerne pas seulement le débit. Les progrès sont particulièrement visibles sur les tâches de terminal et de travail agentique, même si Lightning reste derrière les meilleurs modèles frontier en qualité absolue.
NVIDIA met aussi en avant PinchBench, qui mesure le temps nécessaire pour terminer un ensemble de tâches à précision comparable. D’après son article technique sur Nemotron 3.5 Lightning, le modèle atteint 86 % de précision et achève 10 000 tâches en environ 17 heures GPU H100, contre environ 24 heures pour Qwen 3.6 35B à précision comparable. C’est une mesure plus pertinente pour un agent que la seule vitesse token par token : l’objectif est de terminer correctement une tâche, pas simplement de générer vite.
Ces comparaisons restent à lire avec prudence. Une performance publiée par l’éditeur, un endpoint optimisé par un tiers et un serveur interne ne répondent pas à la même question. Avant toute décision, il faut reproduire les tâches, les contraintes et les erreurs de son propre produit.
Le frontier planifie, Lightning exécute
Le meilleur positionnement de Nemotron 3.5 Lightning n’est probablement pas celui d’un modèle unique placé devant toutes les demandes. Dans un agent de longue durée, une minorité d’étapes exige une stratégie complexe. Beaucoup d’autres consistent à appeler un outil, vérifier un résultat, extraire des champs, appliquer un format ou reprendre une erreur connue.
On peut donc répartir le travail :
- un modèle frontier traite les décisions ambiguës, la planification, les arbitrages et les synthèses difficiles ;
- un routeur choisit le modèle selon la qualité nécessaire, la latence, le coût et le contexte de la session ;
- Nemotron 3.5 Lightning exécute les sous-tâches nombreuses, structurées et vérifiables ;
- les résultats, erreurs et preuves reviennent à l’orchestrateur pour décider de la suite.
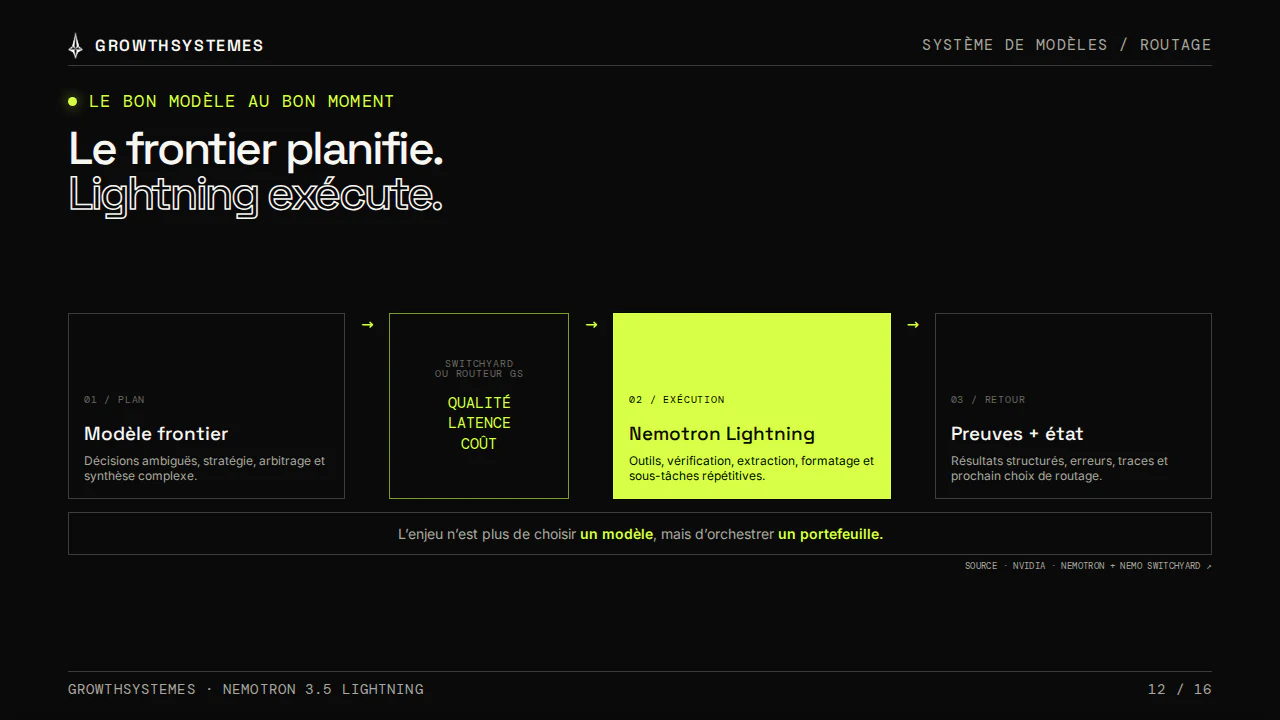
NVIDIA développe cette logique avec NeMo Switchyard, un proxy et une bibliothèque Rust capables de présenter une interface stable devant plusieurs backends. Le projet traduit notamment les formats OpenAI Chat, OpenAI Responses et Anthropic Messages, puis route vers vLLM, NVIDIA NIM, Ollama ou un endpoint compatible OpenAI.
Quatre stratégies sont documentées : classification de la requête, routage selon l’étape de la session, escalade après une première réponse et distribution aléatoire pour les expérimentations. Switchyard est néanmoins annoncé comme pré-alpha. Ses API et ses algorithmes peuvent changer avant la version 1.0 ; nous ne le considérerions pas encore comme un composant de production sans couche de contrôle supplémentaire.
Quel matériel pour déployer Nemotron 3.5 Lightning ?
NVIDIA documente plusieurs générations de GPU, dont Blackwell, Hopper et Ampere avec W4A16. Deux options illustrent bien les usages possibles.
Le DGX Spark vise le poste de travail local. Il propose 128 Go de mémoire unifiée et 273 Go/s de bande passante. NVIDIA fournit une voie de déploiement mono-système et un draft model DSpark adapté à la faible concurrence. Cette machine est cohérente pour prototyper, utiliser un assistant personnel ou faire fonctionner un petit nombre d’agents locaux.
La RTX PRO 6000 Blackwell Server Edition dispose de 96 Go de GDDR7 et d’une bande passante annoncée de 1 597 Go/s. Notre configuration à deux GPU vise un service partagé, avec davantage de cache KV et de concurrence. Les caractéristiques officielles sont disponibles sur les pages du DGX Spark et de la RTX PRO 6000 Blackwell Server Edition.
Acheter le GPU avant d’avoir défini la charge reste toutefois une erreur classique. Le bon dimensionnement dépend du contexte moyen, du nombre de requêtes simultanées, du temps avant le premier token attendu, de la taille des réponses et du niveau de redondance souhaité.
Pour quels usages en entreprise ?
Nous évaluons le modèle sur trois surfaces applicatives différentes :
- Ontologie × Hermes, pour des agents métier capables d’exécuter des actions gouvernées dans un contexte explicite ;
- Open WebUI, pour un assistant interne connecté au RAG et aux connaissances de l’organisation ;
- OpenCode, pour déléguer des boucles de code, terminal, validation et correction.
Le moteur d’inférence peut être commun, mais les critères de réussite ne le sont pas. Un assistant interne doit citer correctement ses sources. Un agent métier doit respecter ses autorisations et produire des actions auditables. Un agent de code doit savoir interpréter les erreurs, lancer les bons tests et s’arrêter lorsqu’il n’a plus de voie sûre.
Pour chacun de ces usages, nous recommandons de mesurer au moins six dimensions :
- la qualité de la tâche terminée ;
- la sélection des outils et la validité de leurs arguments ;
- le temps total, incluant le prefill, le raisonnement et les actions ;
- la consommation de VRAM, l’énergie, la saturation et le cache ;
- la stabilité sur les exécutions longues ;
- le coût par tâche utile, plutôt que le seul coût par token.
Le protocole le plus sain consiste à figer un jeu de tâches représentatif pour chaque surface et à comparer Lightning à deux références : un modèle frontier et le meilleur modèle local déjà en production. C’est seulement à ce niveau que l’on peut décider quelles requêtes lui confier.
Notre avis sur Nemotron 3.5 Lightning
Nemotron 3.5 Lightning réunit trois qualités rarement alignées dans un petit modèle agentique : une architecture parcimonieuse, un checkpoint NVFP4 facile à servir et une chaîne d’entraînement largement documentée. Nos premières mesures confirment qu’il peut fournir beaucoup de débit sur deux GPU professionnels tout en conservant un profil interactif à concurrence modérée.
Sa limite est tout aussi importante : il ne remplace pas un modèle frontier sur les tâches ambiguës ou les raisonnements les plus difficiles. Sa vraie valeur apparaît dans un système de modèles, lorsqu’on lui confie un grand volume d’étapes spécialisées, contrôlables et répétitives.
Autrement dit, la question n’est plus « quel est le meilleur modèle ? », mais « quel modèle doit traiter chaque étape, avec quel niveau de preuve, de latence et de coût ? ». Pour cette couche d’exécution locale, Nemotron 3.5 Lightning est aujourd’hui l’un des modèles open weights les plus intéressants à évaluer.