Qwen3.8-27B est un modèle open weights dense de 27 milliards de paramètres, capable de traiter nativement du texte, des images et de la vidéo. Sa promesse est ambitieuse : réunir dans un seul checkpoint le coding, le travail agentique, le raisonnement et l’analyse visuelle, tout en restant assez compact pour fonctionner sur un unique GPU professionnel.
Nous avons déployé son checkpoint FP8 officiel sur une NVIDIA RTX PRO 6000 Blackwell Server Edition, exposé 262 144 tokens de contexte et exécuté 576 requêtes de benchmark. Elles ont toutes réussi. En charge, le modèle atteint 639,66 tokens de sortie par seconde à 32 requêtes concurrentes. Avec un objectif de latence interactif, la concurrence 4 reste le dernier profil dont le TTFT p95 est inférieur à une seconde et la latence complète p95 inférieure à dix secondes.
Le débit n’est pourtant qu’une partie du sujet. Qwen3.8-27B apporte aussi une vision native, plusieurs niveaux d’effort de raisonnement et des résultats publics qui le placent parfois au niveau de modèles beaucoup plus grands. Voici ce que son architecture, les benchmarks éditeur et surtout nos mesures réelles permettent d’en conclure.
Qwen3.8-27B en bref
Qwen3.8-27B est un modèle dense multimodal construit sur la fondation architecturale de Qwen3.5. Contrairement à un Mixture-of-Experts comme Nemotron 3.5 Lightning, tous ses paramètres participent au calcul de chaque token. Il demande donc davantage de calcul par passage, mais offre un profil de modèle principal plus généraliste.
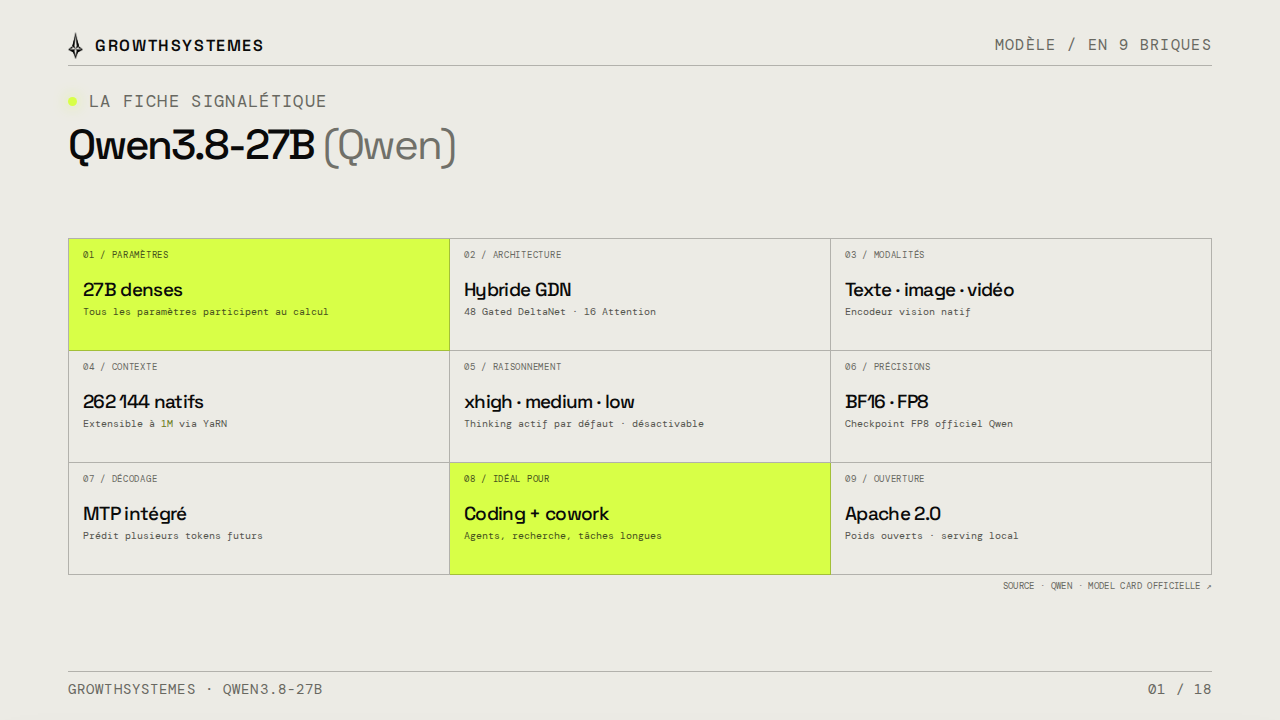
| Caractéristique | Qwen3.8-27B |
|---|---|
| Paramètres | 27 milliards, architecture dense |
| Architecture langage | 48 couches Gated DeltaNet et 16 couches d’attention complète |
| Modalités | Texte, image et vidéo |
| Fenêtre de contexte | 262 144 tokens natifs, extensible jusqu’à environ 1 million avec YaRN |
| Raisonnement | Thinking actif par défaut, niveaux low, medium et xhigh, mode non-thinking |
| Précisions officielles | BF16 et FP8 |
| Décodage | Tête Multi-Token Prediction intégrée |
| Licence | Apache 2.0 |
| Cas d’usage cible | Coding, agents, recherche, analyse documentaire et tâches longues |
La model card officielle de Qwen3.8-27B documente les capacités, les benchmarks et les paramètres de contexte. Qwen publie aussi un checkpoint FP8 officiel, celui que nous avons utilisé pour nos mesures.
Une architecture hybride, mais pas un Mixture-of-Experts
Le mot « hybride » peut prêter à confusion. Qwen3.8-27B ne route pas ses tokens entre des experts comme un MoE. Son hybridation se situe dans la façon de traiter la séquence : le modèle alterne Gated DeltaNet et attention complète.
Ses 64 couches langage sont organisées en 16 blocs identiques :
- trois couches Gated DeltaNet maintiennent un état récurrent et traitent efficacement la séquence ;
- une couche d’attention complète rétablit des interactions globales avec le contexte ;
- ce motif 3:1 est répété seize fois, soit 75 % de Gated DeltaNet et 25 % d’attention complète.
Dans les couches d’attention, le grouped-query attention utilise 24 têtes de requête pour seulement 4 têtes key-value. Cette asymétrie réduit le volume du cache KV et la bande passante nécessaire par rapport à une attention multi-head symétrique. Elle contribue directement à rendre exploitable une fenêtre native de 262K tokens sur un seul GPU de 96 Go.
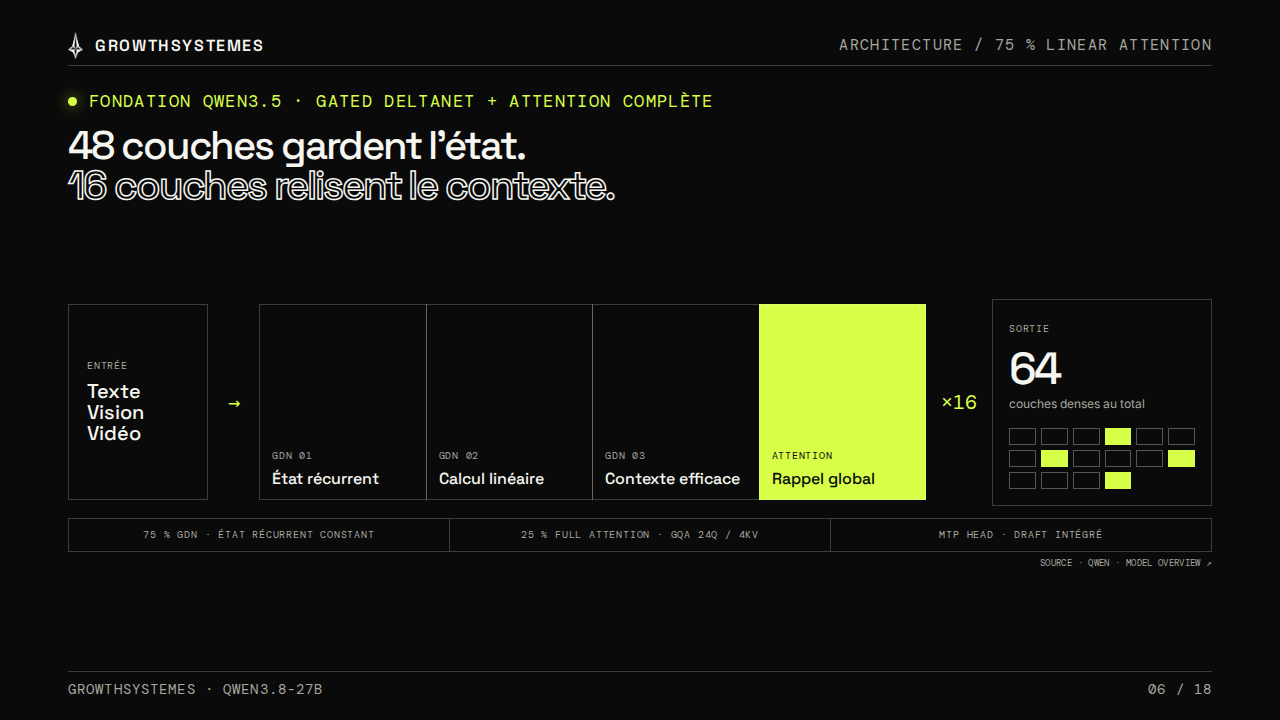
Le modèle possède également une tête Multi-Token Prediction capable de proposer plusieurs tokens futurs. vLLM peut l’utiliser comme draft intégré pour du décodage spéculatif, sans charger un second petit modèle. Nous ne l’avons pas activée pendant cette campagne : son taux d’acceptation, son gain de débit et son coût mémoire doivent encore être mesurés sur notre matériel.
Qwen indique que la génération 3.8 conserve la fondation architecturale de Qwen3.5. Les progrès observés face à Qwen3.6 semblent donc venir surtout de l’entraînement, du post-training, du contrôle du raisonnement et de l’intégration agentique. C’est une interprétation cohérente avec les informations publiées, pas une attribution causale démontrée par Qwen.
Que disent les benchmarks publics ?
Les résultats publiés par Qwen montrent un 27B étonnamment compétitif en code et sur les tâches longues. Par rapport à Qwen3.6-27B, la progression est visible sur plusieurs familles : Terminal Bench 2.1 passe de 63,4 à 73,0, SWE-bench Pro de 53,5 à 61,7 et CoWorkBench de 61,0 à 70,7.
Sur quatre benchmarks de coding présentés dans la model card :
| Benchmark | Qwen3.8-27B | Qwen3.6-27B | Qwen3.7-Plus | Opus4.6 Max |
|---|---|---|---|---|
| Terminal Bench 2.1 | 73,0 | 63,4 | 64,0 | 78,2 |
| SWE-bench Pro | 61,7 | 53,5 | 57,6 | 53,4 |
| NL2Repo-Bench | 42,3 | 36,2 | 41,1 | 47,6 |
| LiveCodeBench v6 | 90,3 | 83,9 | 89,6 | 88,8 |
Cette table ne prouve pas une supériorité générale. Qwen3.8-27B devance ici Opus4.6 Max sur SWE-bench Pro et LiveCodeBench, mais reste derrière sur Terminal Bench et NL2Repo-Bench. Les protocoles ne sont pas tous identiques : certains tests utilisent un harness Claude Code, le score Opus sur SWE-bench Pro est son score officiel, et plusieurs benchmarks de la model card sont internes à Qwen.
La partie multimodale est néanmoins un signal fort. Dans la table vision publiée par Qwen, le 27B devance Opus4.6 Max sur les dix lignes où les deux modèles disposent d’un score. Il atteint notamment 84,3 sur OSWorld-Verified contre 72,7 pour Opus, et 38,6 sur SWE-MM contre 27,1. Là encore, prompts, scaffolds et juges comptent autant que le score final. Ces résultats justifient une évaluation en conditions réelles, pas un verdict universel.
Notre déploiement sur une RTX PRO 6000
Nous avons servi Qwen3.8-27B-FP8 E4M3 sur le GPU0 d’un serveur équipé de deux RTX PRO 6000 Blackwell Server Edition de 96 Go. Qwen fonctionne en tensor parallelism 1 : un seul GPU effectue son calcul. Nemotron reste chargé sur le GPU1, mais son utilisation calcul moyenne est restée nulle pendant la campagne.
La chaîne expose une API compatible OpenAI avec le raisonnement, le streaming et les appels d’outils. Avant la charge principale, nous avons validé plusieurs points :
- 24 requêtes sur 24 réussies lors du smoke test ;
- les modes non-thinking, default, low, medium et xhigh ;
- un appel d’outil structuré avec le parser
qwen3_coder; - les health checks directs, Nginx et Nemotron ;
- aucun redémarrage ni erreur de service.
La campagne principale comporte 576 requêtes réussies sur 576, soit 596 978 tokens d’entrée et 147 456 tokens générés, sans échec.
Le FP8 transforme la mémoire économisée en contexte
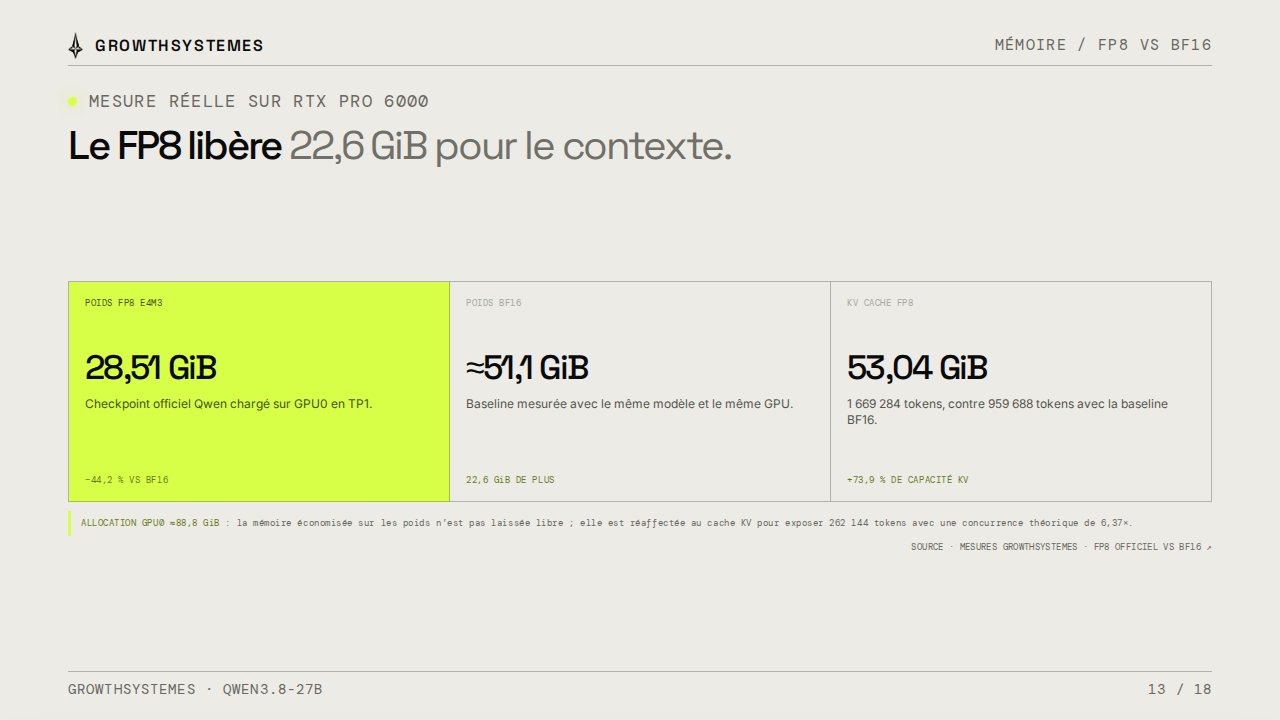
Le checkpoint FP8 occupe 28,51 GiB de poids, contre environ 51,1 GiB pour notre baseline BF16. Le gain est de 22,6 GiB, soit 44,2 %. Cette mémoire n’est pas laissée vide : elle est réaffectée au cache KV.
| Allocation | FP8 | BF16 |
|---|---|---|
| Poids | 28,51 GiB | ≈51,1 GiB |
| Capacité du cache KV | 1 669 284 tokens | 959 688 tokens |
| Taille du cache KV en FP8 | 53,04 GiB | - |
L’allocation du GPU0 atteint ainsi environ 88,8 GiB après charge. Le serveur peut exposer les 262 144 tokens natifs avec une concurrence théorique de 6,37 séquences à la longueur maximale. Autrement dit, la quantification sert ici moins à faire tenir le modèle qu’à augmenter fortement sa capacité opérationnelle.
Nos résultats avec 1 024 tokens d’entrée et 256 de sortie
Nous avons fait varier la concurrence de 1 à 32 avec 1 024 tokens d’entrée et 256 tokens de sortie. Le protocole utilise le streaming OpenAI Chat, un décodage greedy, le thinking désactivé et l’EOS ignoré afin de conserver des sorties comparables.
| Concurrence | Requêtes/s | Goodput | Tokens de sortie/s | Tokens totaux/s | TTFT p95 | Latence E2E p95 |
|---|---|---|---|---|---|---|
| 1 | 0,175 | 0,175 | 44,84 | 226,36 | 306 ms | 5,74 s |
| 2 | 0,320 | 0,320 | 81,95 | 413,71 | 466 ms | 6,29 s |
| 4 | 0,594 | 0,594 | 152,14 | 768,10 | 842 ms | 6,80 s |
| 8 | 1,095 | 0,137 | 280,32 | 1 415,14 | 1,609 s | 7,54 s |
| 16 | 1,765 | 0,097 | 451,93 | 2 281,53 | 2,992 s | 9,46 s |
| 32 | 2,499 | 0 | 639,66 | 3 229,41 | 5,617 s | 13,27 s |
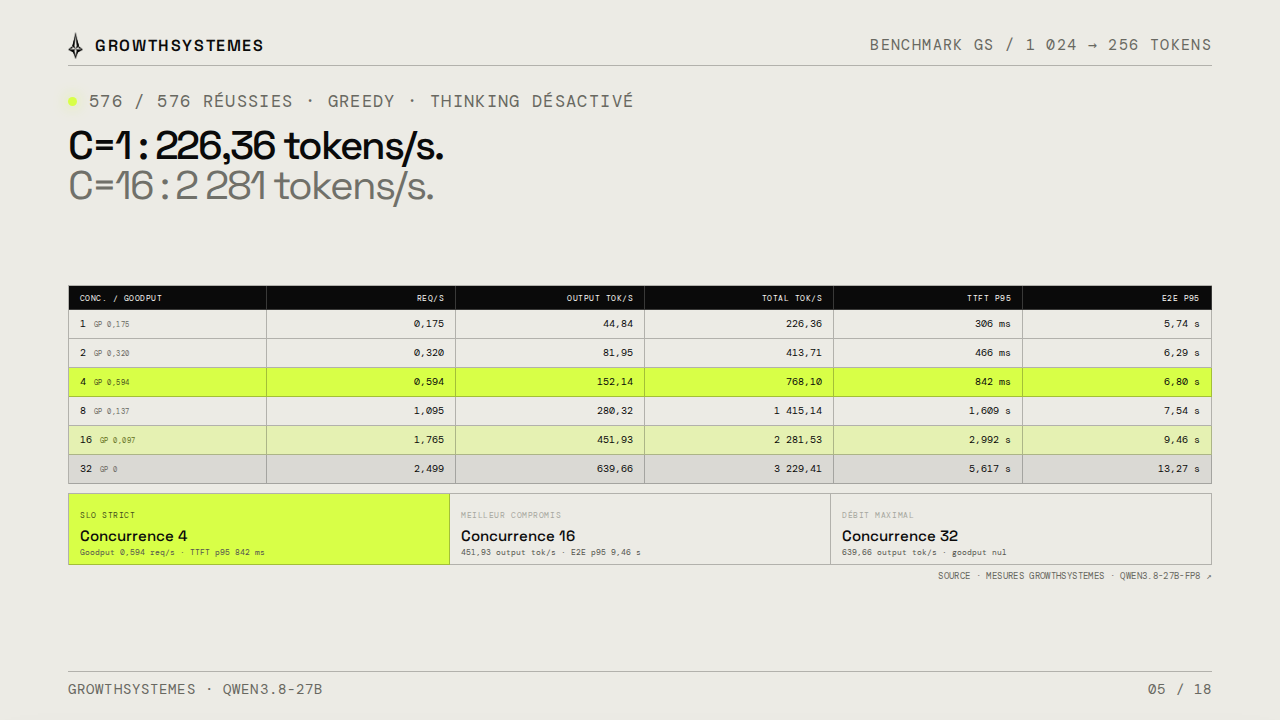
Notre définition du goodput ne compte que les requêtes dont le TTFT est inférieur à une seconde et la latence complète inférieure à dix secondes. Cette distinction change la lecture du débit brut :
- pour un SLO interactif strict, la concurrence 4 est le dernier profil qui respecte simultanément les deux seuils en p95 ;
- pour un service partagé, la concurrence 16 offre le meilleur compromis avec 451,93 tokens de sortie par seconde et une latence E2E p95 de 9,46 secondes ;
- pour du batch, la concurrence 32 maximise le débit à 639,66 tokens de sortie par seconde, avec un pic instantané à 1 123 tokens par seconde, mais son goodput est nul selon notre SLO.
Le débit total de 226,36 tokens par seconde à concurrence 1 inclut les tokens d’entrée et de sortie. Le débit de génération par requête est alors de 44,84 tokens de sortie par seconde. Cette distinction évite de comparer deux métriques qui ne répondent pas à la même question.
L’efficacité énergétique augmente aussi avec la charge. À concurrence 32, nous mesurons 5 082 tokens par wattheure en FP8 contre 3 396 en BF16, soit environ 49,6 % de mieux. La puissance relevée cumule les deux GPU, même si Nemotron n’effectuait aucun calcul sur le second.
Quel mode de raisonnement choisir ?
Qwen3.8-27B permet de désactiver le thinking ou de choisir plusieurs niveaux d’effort. Pour mesurer leur comportement, nous avons exécuté huit problèmes, deux répétitions et cinq modes, soit 80 générations principales à concurrence 1.
| Mode | Réussite | Troncatures | Reasoning moyen | Complétion moyenne | E2E p95 |
|---|---|---|---|---|---|
| Non-thinking | 13/16 · 81,2 % | 2 | 0 token | 618 tokens | 22,17 s |
| Default | 16/16 · 100 % | 0 | 347 tokens | 390 tokens | 14,85 s |
| Low | 14/16 · 87,5 % | 2 | 322 tokens | 540 tokens | 22,12 s |
| Medium | 15/16 · 93,8 % | 1 | 320 tokens | 527 tokens | 19,38 s |
| Xhigh | 16/16 · 100 % | 0 | 299 tokens | 353 tokens | 13,49 s |
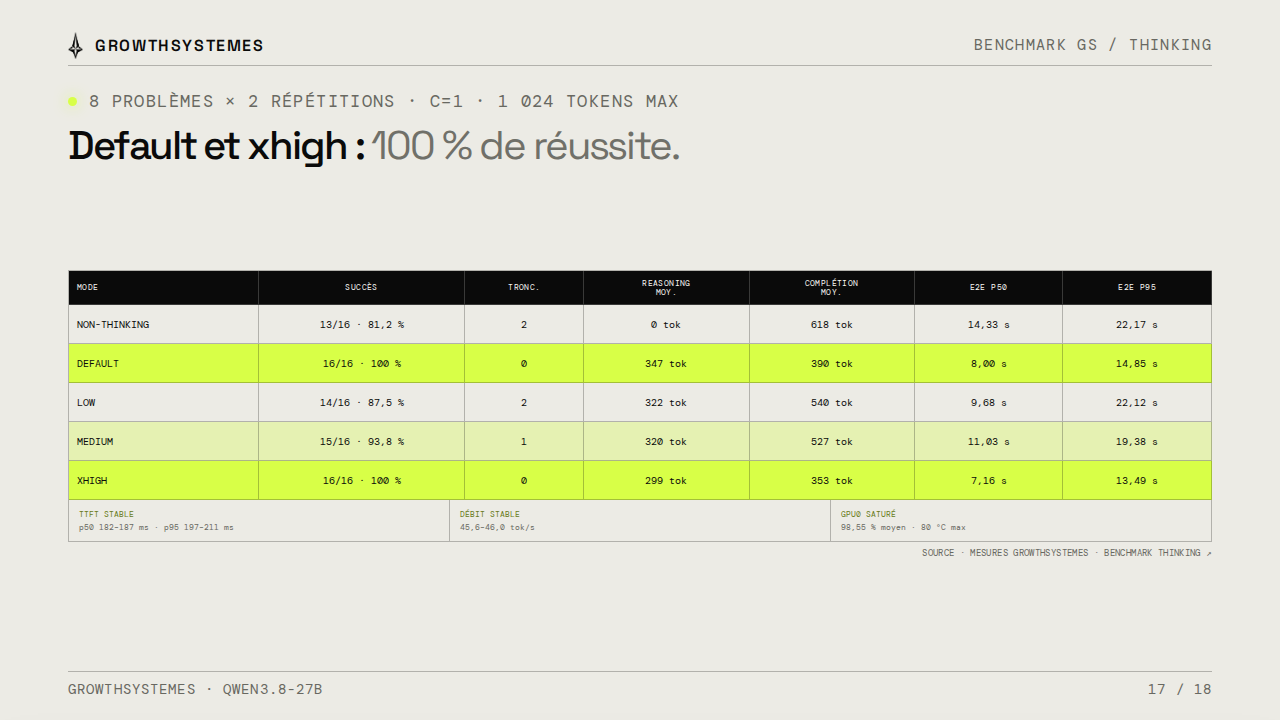
Le TTFT varie peu entre les modes : environ 182 à 187 ms en p50 et 197 à 211 ms en p95. Le débit de génération reste lui aussi stable, entre 45,6 et 46 tokens par seconde. Les écarts de latence complète viennent donc principalement de la longueur totale du raisonnement et de la réponse.
Notre recommandation opérationnelle est simple :
- medium pour l’usage général ;
- default ou xhigh lorsque la fiabilité prime sur le budget de tokens ;
- non-thinking pour les réponses simples, structurées et facilement vérifiables ;
- au moins 2 048 tokens de sortie pour les tâches de raisonnement.
Cette dernière règle vient d’un test ciblé : plusieurs échecs à 1 024 tokens étaient des troncatures. Les huit reprises exécutées avec une limite de 2 048 tokens ont toutes réussi.
Il faut toutefois garder l’échelle de l’expérience en tête. Huit problèmes et deux répétitions ne mesurent pas l’intelligence générale du modèle. Default correspond nominalement à xhigh, et l’échantillonnage utilise une température de 1 : l’écart de latence observé entre ces deux lignes peut relever de la variance.
La vision change le rôle du modèle local
Nemotron 3.5 Lightning est particulièrement intéressant comme couche d’exécution rapide pour des sous-tâches textuelles. Qwen3.8-27B vise un rôle plus large : il peut devenir le modèle local principal d’un système agentique, car la même instance reçoit du texte, des captures d’écran, des documents et de la vidéo.
Nous l’évaluons sur trois surfaces :
- Ontologie × Hermes, pour agir sur des objets métier gouvernés et lire des documents, captures ou schémas ;
- Open WebUI, pour un assistant interne relié au RAG, aux pièces jointes et aux connaissances de l’organisation ;
- OpenCode, pour des boucles de repository, terminal, correction et validation.
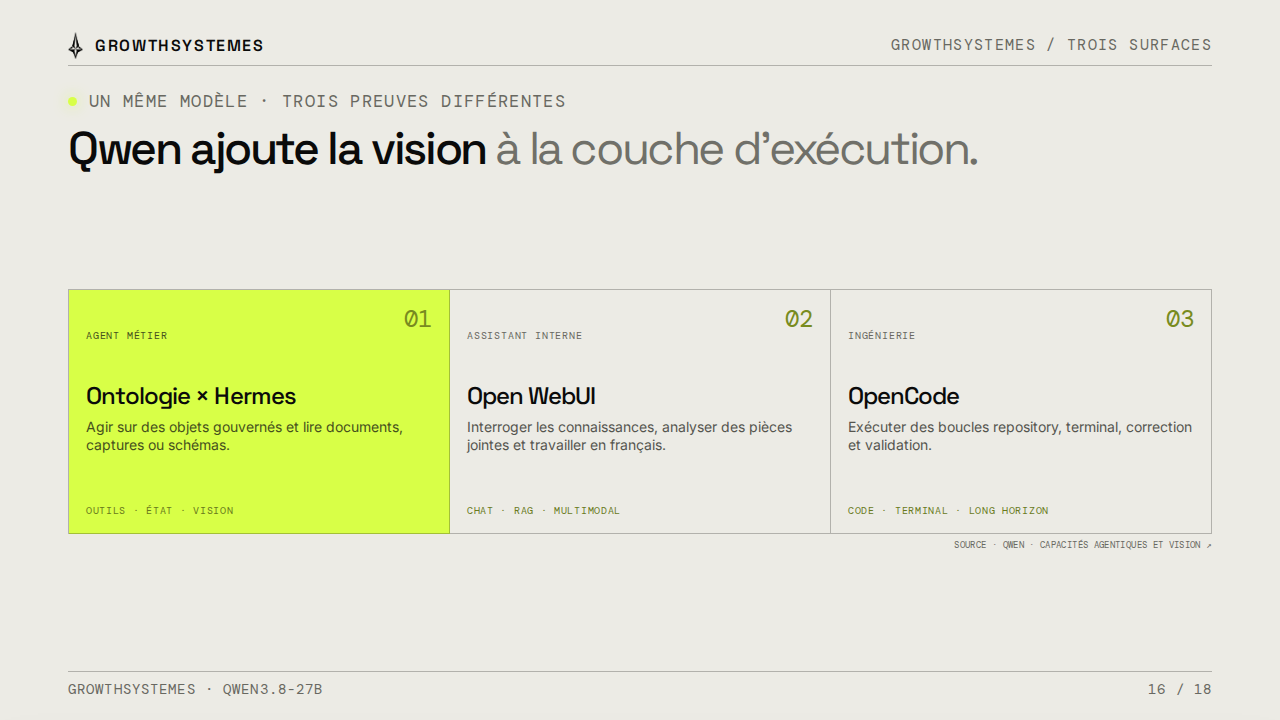
La vision native ne dispense pas d’un protocole d’évaluation. Un agent computer-use doit comprendre l’interface, choisir la bonne action et vérifier son effet. Un assistant documentaire doit extraire fidèlement les éléments visuels et citer ses sources. Un agent de code doit terminer une tâche, lancer les validations pertinentes et s’arrêter lorsqu’il ne dispose plus d’une voie sûre.
Le parser fait également partie du système. Si les blocs de raisonnement et les appels d’outils sont interprétés comme du texte brut, un bon modèle agentique devient inutilisable. Nous avons validé les parsers qwen3 et qwen3_coder, mais chaque intégration doit encore tester les arguments d’outils, les sorties structurées, les erreurs et les conversations multi-tours.
262K natifs, un million seulement si nécessaire
La fenêtre native de 262 144 tokens couvre déjà des dépôts, des documents longs et des sessions agentiques importantes. Qwen documente une extension jusqu’à environ un million de tokens avec YaRN, généralement avec un facteur 2× ou 4×.
Cette extension n’est pas gratuite. Elle augmente les besoins en cache, le temps de prefill et la pression sur la concurrence. Un facteur YaRN statique reste en outre actif sur les prompts courts et peut dégrader leurs performances. Pour une charge mixte, il est souvent plus propre de maintenir deux profils : un endpoint natif 262K pour le trafic courant et un endpoint long contexte réservé aux tâches qui le nécessitent vraiment.
Notre avis sur Qwen3.8-27B
Qwen3.8-27B réunit quatre qualités rarement présentes dans un modèle local de cette taille : de solides capacités de code, une vision native, un raisonnement pilotable et une fenêtre de contexte très longue. Le checkpoint FP8 officiel tient sur une RTX PRO 6000 tout en laissant 53,04 GiB au cache KV, et notre campagne confirme sa stabilité sous charge.
Sa contrepartie vient de son architecture dense. À concurrence 1, nous mesurons environ 45 tokens de sortie par seconde, bien moins que les 198 tokens par seconde observés avec Nemotron 3.5 Lightning dans notre autre campagne. Qwen n’occupe donc pas exactement la même place : Nemotron reste un excellent exécuteur rapide de sous-tâches spécialisées, tandis que Qwen peut prendre en charge des tâches plus générales, multimodales et longues.
Notre configuration de départ serait medium au quotidien, default ou xhigh lorsque la fiabilité prime, avec une limite de sortie d’au moins 2 048 tokens pour le raisonnement. Pour le serving, concurrence 4 convient à un SLO strict, concurrence 16 à un service partagé et concurrence 32 au batch.
Le vrai verdict viendra maintenant des tâches terminées : correction de code, analyse de documents, navigation visuelle, appels d’outils et reprise après erreur. Mais au vu des résultats publics et de nos mesures locales, Qwen3.8-27B mérite d’être évalué comme modèle principal d’une infrastructure IA open weights.